关于BUS通信系统的一些思考(一)
目录
概述
如何保证一个进程或线程能安全稳定地把一段消息发送到另一个进程和线程,甚至是另一台机器的进程或线程,再或是要通过代理转发到另一个进程或线程,一直是一个比较麻烦的问题。
最近看了一些和BUS系统有关的东西。对于游戏服务器集群所使用的BUS通信系统有一些想法和思路,但是由于我对其他类型的业务和框架不是很熟悉,有些想法可能仅是站在游戏服务端的立场上,所以可能有些地方还有一些局限性。
如何保证一个进程或线程能安全稳定地把一段消息发送到另一个进程和线程,甚至是另一台机器的进程或线程,再或是要通过代理转发到另一个进程或线程,一直是一个比较麻烦的问题。
最近看了一些和BUS系统有关的东西。对于游戏服务器集群所使用的BUS通信系统有一些想法和思路,但是由于我对其他类型的业务和框架不是很熟悉,有些想法可能仅是站在游戏服务端的立场上,所以可能有些地方还有一些局限性。
C++ 11 标准发布,各大编译器都开始支持里面的各种新特性,其中一项比较有意思的就是lambda表达式。
C++ 11 Lambda表达式的四种声明方式
这四个声明式都会返回一个匿名的仿函数实例)。 这里有一个比较重要的一点,就是他是一个仿函数实例,而不是直接一个函数。
C++11标准里有动态模板参数已经是众所周知的事儿了。但是当时还有个主流编译器还不支持。 但是现在,主要的编译器。VC(Windows),GCC(Windows,Linux),Clang(Mac,IOS)都已经支持了。所以就可以准备用于生产环境了。 type_traits没啥好说的。主要是一些静态检测。主要还是要看动态模板参数和他们两的结合使用上。 动态模版参数标准文档见: http://www.open-std.org/jtc1/sc22/wg21/docs/papers/2007/n2242.pdf 和 http://www.open-std.org/jtc1/sc22/wg21/docs/papers/2008/n2555.pdf 虽然贴出来了。估计是没人看得。所以就直接说重点。
前几天我们项目的日志系统出现了一点问题,但是一直没有时间去深究。 昨天在同事的帮助下,无意中猜了一种可能性,结果还真被我猜中了,于是今天就特别研究了一下,记录下来。
其实主要问题是三个模块。
关键在于静态库a里有一个静态全局变量,没错就是我们的日志模块。 原先的这个静态的模块中的静态全局变量是有构造函数的,也就是构造函数干了点事情。
用过std和boost的function对象和bind函数的童鞋们都知道这玩意用起来腰不酸了,腿不疼了,心情也舒畅了。先上一个简单得示例:
std::string str;
std::function func = std::bind(&std::string::at, &str);
bool is_empty = func();
但是这是怎么做到的呢?看完源码以后,你会发现这里面有着一些很巧妙的设计。
项目里面引入了Lua,就特别学习了一下。
其实对于理解Javascipt的人来说,Lua也很容易理解,因为他们太多的地方相像了。
初步看来,Lua的设计模式和思想很像Javascript,也是原型模型(Javascript里叫prototype,Lua里是metatable)
终于到最后的虚继承了。
测试代码如下:
#include
#include
#include
#include
#include
#include
#include

class foo_a
{
public:
    virtual ~foo_a(){}
    virtual void info() {
        printf("%s:%d\n", __FUNCTION__, __LINE__);
    }

    void print(){
        printf("%s:%d\n", __FUNCTION__, __LINE__);
    }
};

class foo_l
{
public:
    int l;
    foo_l(): l(1){}

    virtual void info() {
        printf("%s:%d\n", __FUNCTION__, __LINE__);
    }
};

class foo_r: virtual public foo_a
{
public:
    int r;
    foo_r(): r(2){}
};

class foo_c: virtual public foo_l, public foo_r
{
public:
    virtual void info() {
        printf("%d,%d. %s:%d\n", l, r, __FUNCTION__, __LINE__);
    }
};


int main(int argc, char* argv[]) {
    void (foo_a::*vptr1)() = &foo_a::info;
    void (foo_l::*vptr2)() = &foo_l::info;
    void (foo_a::*ptr)() = &foo_a::print;

    foo_c c;
    foo_r r;
    foo_a a;

    printf("pword size = %d\n", (int)(sizeof(size_t)));
    printf("address of &foo_a::info = 0x%llxH\n", &foo_a::info);
    printf("pointer to &foo_a::info = 0x%llxH\n", vptr1);
    printf("sizeof vptr = %d\n", (int)(sizeof(vptr1)));

    (a.*vptr1)();
    (r.*vptr1)();
    (c.*vptr1)();
    (c.*vptr2)();
    c.info();

    (c.*ptr)();

    return 0;
} 因为是兼容虚继承和非虚继承的,所以赋值的部分的汇编是一样的。这里就不贴了。关键在于执行期它是怎么找到虚基类的。请往下看:
接下来是多重继承,用到的测试代码如下所示:
#include
#include
#include
#include
#include
#include
#include

class foo_a
{
public:
    virtual ~foo_a(){}
    virtual void info() {
        printf("%s:%d\n", __FUNCTION__, __LINE__);
    }
};

class foo_b
{
public:
    virtual ~foo_b(){}

    // 这个函数用于试foo_b的结构与foo_a不同
    // 以防止VC对foo_a和foo_b的`vcall'{8}'的代码合并
    virtual void inspect() {
        printf("%s:%d\n", __FUNCTION__, __LINE__);
    }

    virtual void info() {
        printf("%s:%d\n", __FUNCTION__, __LINE__);
    }

    void print() {
        printf("%s:%d\n", __FUNCTION__, __LINE__);
    }
};


class foo_c: public foo_a, public foo_b
{
public:
    virtual void info() {
        printf("%s:%d\n", __FUNCTION__, __LINE__);
    }
};


int main(int argc, char* argv[]) {
    void (foo_a::*vptr1)() = &foo_a::info;
    void (foo_b::*vptr2)() = &foo_b::info;
    void (foo_b::*ptr)() = &foo_b::print;

    foo_c c;
    foo_b b;
    foo_a a;


    printf("word size = %d\n", (int)(sizeof(size_t)));
    printf("address of &foo_a::info = 0x%llxH\n", &foo_a::info);
    printf("pointer to &foo_a::info = 0x%llxH\n", vptr1);
    printf("address of &foo_b::info = 0x%llxH\n", &foo_b::info);
    printf("pointer to &foo_b::info = 0x%llxH\n", vptr2);
    printf("sizeof vptr = %d\n", (int)(sizeof(vptr1)));

    (a.*vptr1)();
    (b.*vptr2)();
    (c.*vptr1)();
    (c.*vptr2)();

    (c.*ptr)();

    return 0;
} 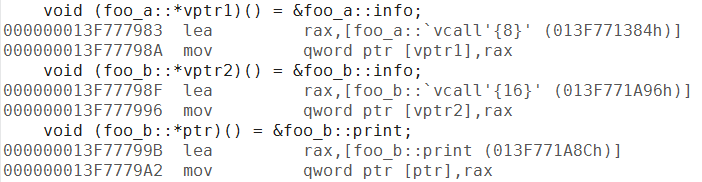
最近在《C++对象模型》一书里说到的virtual的成员函数指针,低于128的被cfront编译器认为是虚表偏移量(支持子类对父类函数的覆盖)。VC只是提了下单继承、多继承和虚继承的实现方案不同,GCC没有提及,所以就专门稍微深入分析研究下他们的实现机制。
今天看到一个小例子,发现了一个小trick。见代码:
#include
#include

class base_1
{
public:
    int a;
};

class base_2
{
public:
    int b;
};

class base_3: public base_1, public base_2
{
public:
    int c;
};

int main(int argc, char* argv[]) {

    printf("&base_1::a = %p\n", &base_1::a);
    printf("&base_2::b = %p\n", &base_2::b);
    printf("&base_3::a = %p\n", &base_3::a);
    printf("&base_3::b = %p\n", &base_3::b);
    printf("&base_3::c = %p\n", &base_3::c);


    base_3 t;
    t.a = 1;
    t.b = 2;
    t.c = 3;

    typedef int (base_3::*tip);
    tip pm = NULL;

    printf("base_3::a = %d\n", t.base_3::a);
    printf("base_3::b = %d\n", t.base_3::b);
    printf("base_3::c = %d\n", t.base_3::c);

    pm = &base_3::a;
    printf("base_3::a(%p) = %d(ptr)\n", pm, t.*pm);
    pm = &base_3::b;
    printf("base_3::b(%p) = %d(ptr)\n", pm, t.*pm);
    pm = &base_3::c;
    printf("base_3::c(%p) = %d(ptr)\n", pm, t.*pm);

    return 0;
}
猜猜看这个代码输出什么? 答案是:
最近看了glibc的ptmaoolc,Goolge的tcmalloc和jemalloc,顺便做了一点记录。可能有些地方理解地不太对,如有发现还请大神指出。
各种malloc的内存分配管理方式离不开操作系统的内存布局策略。
最近看了点typescript的东西,加上以前看过的一点点Node.js,所以就想把他们系统地整理一下。
这玩意搞过Web开发的应该都知道吧,Javascript的语法我就不废话了,挺简单的。这里总结几个Javascript的核心机制部分吧。
慢慢一点一点看看Boost,这段时间就Asio库吧。 据说这货和libevent的效率差不多,但是Boost的平台兼容性,你懂得。还有它帮忙干掉了很多线程安全和线程分发的事情。
使用ASIO操作信号量有一个注意事项,不允许再使用其他库或工具管理信号量(如signal() 或 sigaction()函数)
GCC4.8发布啦,这个脚本在之前4.7的基础上做了点改进,移除一些过时的组件,增加了检测不到时自动下载源码包
PS:4.8.1开始全面支持C++11特性,并且脱离了ppl库,gdb也开始脱离ppl库了
使用代码生成代码是一件十分美妙的事情,于是有了各种代码生成器。但是生成代码,意味着要有对生成规则的分析和处理。 Boost.Spirit 就是这么一个语法分析工具,它实现了对上下文无关文法的LL分析。支持EBNF(扩展巴科斯范式)。 Boost.Spirit 的使用真的是把模板嵌套用到了极致。确实这么做造成了非常强的扩展性,生成的代码也非常高效,但是嵌套的太复杂了,对于初学者而言真心难看懂。 你能想象在学习阶段一个不是太明白的错误导致编译器报出的几十层模板嵌套错误信息的感受吗?而且,这么复杂的模板嵌套还直接导致了编译速度的巨慢无比。 其实在之前,我已经使用过Spirit的Classic版本,即1.X版本,但是过多的复制操作让我觉得当时用得很低效,还好分析的内容并不复杂所以没。体现出来 这回就来研究下功能更强劲的2.X 版本。
C++确实是一门复杂的语言。包括之前查看了一些C++11的文档和做了一些实践和总结,越来越觉得C++是门神奇的语言,也是个陷阱多多的语言。 我现在开发过程中最主要使用的语言就是C++,所以了解C++的一些细节和问题非常重要,后来看到某大神的一篇文章《C++的坑多吗?》,激起了我专门去看一看关于C++的一些常见的设计方法和问题的书。就是刚才提到的文章里有说的《Effecitve C++》和《More Effecitve C++》 共90个条款,所以说是90个坑。
终于要离开学校了,终于有时间可以静下来看看之前导师推荐的书籍。之前有看到说《程序员修炼之道》是对程序员影响最为深刻的书, 就从它开始吧。用这个还算可以的音响听着音乐,看书很惬意啊。 顺便吐槽下京东,我买了本地有货的三本书,三天了我还没见到。这效率实在是fuck。 第一本书的第一章是电子版上看的,还好我有kindle。这里基本上说的是沟通方面的。我发现我的沟通确实有点问题,不太主动,表达含糊。之前只和ultramanhu交流比较多,可能是多年的默契吧,表达清楚意思不怎么费劲。现在的一起合租的xboy(和qboy很像啊),和他交流经常文不对题,开始我总以为他习惯岔开话题,但是后来发现在其他有些人身上也出现过这种问题。看来我的表达力确实有问题,一直说ben大神的表达力低下,其实他只是我这种更恶化一些罢了。不管怎么说,之前看到过个视频,我觉得很有道理,对世界的理解应该是 “知其然 — 知其所以然 – 知其知其所以然 – 知其知其所以然所以然”。别人也是属于世界的一部分,了解别人看待事物和自己不一样、了解别人看待事物的角度、了解别人为什么和自己看待事物的和自己不一样,都是自身对这个世界的理解。同样,自己要表述的意思让各种各种各样的人有理解并且有兴趣听也是自身表达能力的一种体现。Maybe,这就是我大学生活孑然一身(不完整啊)的原因吧。T_T “注重实效的哲学”,其中最重要的部分当属那个WISDOM离合诗了吧。
这是我对C++新特性系统学习的最后一部分,之后就靠实践中再来看新标准的新特性啦。
在之前,我对这部分没太在意,直到看到了一篇文章 [http://blog.csdn.net/pongba/article/details/1659952](http://blog.csdn.net/pongba/article/details/1659952) 才意识到,C++的多线程操作也是个麻烦的问题。

简而言之,C++编译器在进行编译优化的时候,认为当前是单进程的,并且遵循**可观察行为**(Observable Behavior)不变的原则。就是说在可观察行为不变的情况下,操作是可以被改变顺序的,而单进程可观察行为不变,不代表在多进程的情况下仍然不变。还是上大牛的例子:

_**例子一:**_
| x = y = 0; | |
| 线程1 | 线程2 |
| if(x == 1) ++y; | if(y == 1) ++x; |
完全可以优化成